
Se establece el primer centro de investigación conjunto con una universidad asiática…Nvidia expande su ecosistema global de IA usando el coreano como plataforma
La capacidad de investigación en IA de Corea del Sur acapara la atención mundial…Se espera presentar los primeros resultados de investigación en el segundo semestre del próximo año
Nvidia ha elegido el idioma coreano como punto de partida para el desarrollo de tecnología mundial de aprendizaje en inteligencia artificial. La estrategia consiste en adquirir la tecnología para generar y entrenar datos en coreano para luego expandirla a otros países e idiomas. Esta iniciativa se interpreta como un esfuerzo por ampliar su influencia en el ecosistema global de IA, aprovechando la posición de Corea del Sur como un país con sólida competitividad tecnológica. Sin embargo, respecto a los beneficios comerciales concretos que Nvidia obtendrá de la investigación en coreano, la empresa ha ofrecido explicaciones de principios generales sobre la creación de un ecosistema de IA abierto.
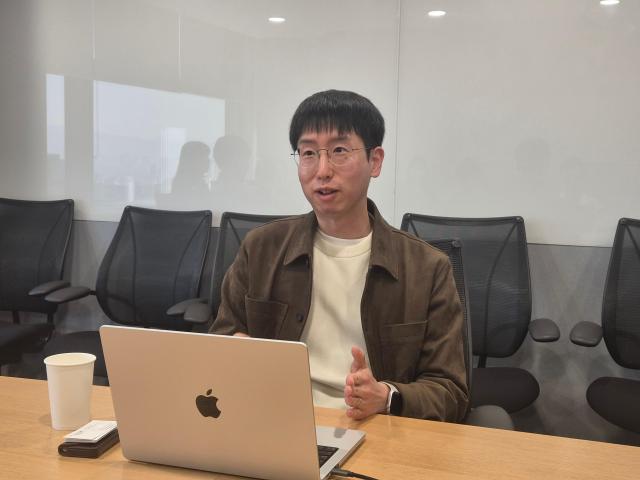
Kim Hyun-woo, gerente de investigación de Nvidia y director del centro conjunto de investigación en IA de Nvidia y el Instituto Coreano de Ciencia y Tecnología (KAIST), explicó en una rueda de prensa celebrada el 10 de noviembre en la oficina de Nvidia Corea ubicada en Gangnam-gu, Seúl, el trasfondo del establecimiento del centro de investigación conjunto: "KAIST se ha convertido en una institución que suscita una atención extraordinaria en el mundo entero".
Kim señaló que "los excelentes resultados de investigación de KAIST y la posición única del coreano como un idioma de recursos intermedios se alinearon perfectamente", y agregó que "la elevada atención de los coreanos hacia la inteligencia artificial creó una oportunidad de oro".
El valor del coreano que Nvidia destaca es su potencial como base de investigación para expandir hacia el mercado mundial de IA. Aunque el coreano no posee recursos de aprendizaje tan abundantes como el inglés o el chino mandarín, se clasifica como un "idioma de recursos intermedios" que contiene más datos que los idiomas minoritarios. Esto representa condiciones favorables para desarrollar y validar nuevas técnicas de aprendizaje de datos.
Kim afirmó que "nuestro objetivo es comenzar con el coreano y desarrollar metodologías de aprendizaje de datos que puedan aplicarse a otros idiomas", y continuó: "no se trata simplemente de cultivar un árbol hermoso, sino de investigar cómo crear un bosque y compartir ese conocimiento con el mundo".
Cuando se le preguntó qué beneficios comerciales aportaría la investigación en coreano a Nvidia, Kim no presentó un modelo de ingresos específico. Respondió: "A nivel empresarial, soñamos con un ecosistema de IA abierto. Nuestro objetivo es investigar metodologías que el mundo entero pueda utilizar, comenzando con nuestro idioma, para que cada país pueda desarrollar la IA en su propia lengua".
El centro de investigación conjunto que Nvidia y KAIST anunciaron en julio pasado es el primer centro conjunto de investigación en IA que Nvidia establece con una universidad en Asia. Ambas organizaciones impulsarán una cooperación de 300 millones de dólares en los próximos cinco años. De esta cantidad, 250 millones de dólares se destinarán a recursos informáticos, mientras que se están discutiendo los modos específicos de operación de los fondos restantes.
Kim subrayó la importancia del hecho de que "grandes empresas tecnológicas de IA a nivel mundial han comenzado a establecer centros de investigación y contratar personal investigador en nuestro país", e indicó su deseo de "demostrar la excelente capacidad de los investigadores coreanos para alentar a más empresas globales a establecer centros de investigación en Corea del Sur".
También dejó abierta la posibilidad de expandir la cooperación a otras universidades. Manifestó que "nuestro objetivo es hacerlo bien y luego abrirlo. No tiene que limitarse solo a Nvidia. Otras empresas también podrán ver la capacidad de Corea del Sur e invertir".
Explicó que esta cooperación tiene un carácter diferente a la que mantiene con la Universidad Nacional de Seúl. El Centro de Tecnología de IA de Nvidia (NVAITC) que Nvidia impulsa con la Universidad Nacional de Seúl se centra en la investigación conjunta y la educación. Por el contrario, el centro de investigación conjunto con KAIST incluye la contratación directa de investigadores de tiempo completo de Nvidia y el suministro de recursos informáticos.
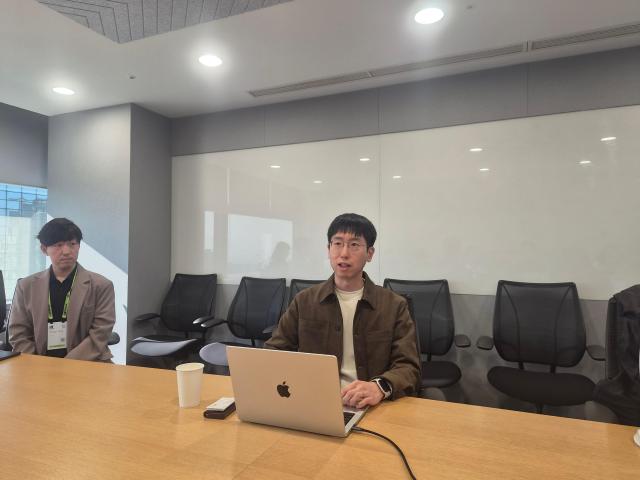
La operación del centro se encuentra aún en sus etapas iniciales. Kim indicó que "hemos comenzado a reclutar investigadores y tenemos previsto contratar a varios durante este año". Se están manteniendo negociaciones con socios de nube de Nvidia en Corea del Sur para asegurar recursos de GPU, aunque la cantidad específica de equipos aún no ha sido confirmada.
Surgieron también preguntas relacionadas con los problemas de liderazgo recientemente identificados en Nvidia, cuestionando si las operaciones del centro continuarían si el director ejecutivo fuera reemplazado. Kim respondió: "No creo ser la persona más indicada para comentar sobre ese aspecto", aunque añadió: "Como director del centro, mi objetivo es completar sin contratiempos la misión encomendada".
El desafío central del centro de investigación conjunto es abordar la escasez de datos de entrenamiento en coreano. Según los materiales presentados, en el conjunto de datos multilingües mC4, los documentos en coreano ascienden a aproximadamente 24 millones, lo que representa solo 1/163 de los 3.930 millones de documentos en inglés.
Kim señaló que "es realmente difícil encontrar conjuntos de datos de alta calidad en coreano públicamente disponibles" y "la escasez es generalizada, no limitada a campos específicos". Continuó explicando: "es difícil cerrar esta brecha solo con datos generados por humanos", y añadió que investigarán la generación de datos sintéticos y técnicas para aprender de manera más eficiente los datos existentes.
Ya se están obteniendo resultados positivos. El conjunto de datos coreano de datos sintéticos "Nemo Trón Persona Corea" que Kim presentó anteriormente ocupó el primer lugar en los conjuntos de datos más populares en HuggingFace a nivel mundial durante diez días. También registró aproximadamente 140.000 descargas.
También han surgido casos de uso de empresas nacionales. Kim señaló que "el conjunto de datos se utilizó en 'K-Exaone 2.5', presentado por LG AI Research el día anterior, lo que constituye un ejemplo de ciclo virtuoso del ecosistema donde las organizaciones comparten logros para crear modelos mejores".
La cuestión de los derechos de autor derivados del uso de datos sintéticos también se identifica como un área de investigación. Kim explicó que es imposible conocer la forma exacta en que los modelos de IA existentes adquirieron los datos originales. El centro se enfocará en generar nuevos datos aprovechando el conocimiento de modelos ya entrenados.
Los resultados de la investigación se harán públicos de manera que no sean monopolizados por una empresa específica. Kim manifestó: "El conjunto de datos Nemo Trón Persona se hizo público para permitir su uso comercial", e indicó que desarrollarán datos y metodologías de entrenamiento que otras empresas también puedan utilizar.
Se proyecta que los primeros resultados de investigación se presentarán en el segundo semestre del próximo año. Kim afirmó: "Hay proyectos interesantes en preparación que podrían presentarse alrededor del segundo semestre del próximo año", y concluyó: "Queremos que la investigación iniciada en nuestro país contribuya al ecosistema global de inteligencia artificial".
* Este artículo ha sido traducido por IA.