
Modelos de OpenAI y Google alcanzan puntuación perfecta en examen de acceso surcoreano, mientras que modelos chinos también registran buenos resultados
El modelo K-Exaone 2.5 del instituto de investigación de LG de Corea del Sur registra el mejor desempeño nacional
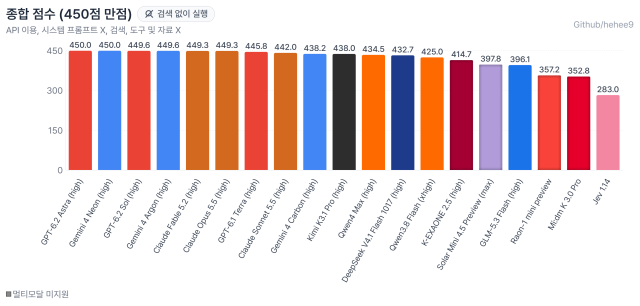
Tras la finalización del examen de acceso a la universidad (Suneung) del año académico 2027, los principales modelos de inteligencia artificial de Estados Unidos, China y Corea del Sur fueron sometidos a prueba con preguntas del examen. Los resultados muestran que los modelos de OpenAI y Google registraron una puntuación perfecta de 450 puntos simultáneamente.
Los modelos del Instituto de Investigación de IA de LG y de Upstage, que participan en el proyecto de modelo fundacional de IA autónomo (independyente) impulsado por el Ministerio de Ciencia y Tecnología de la Información y Comunicaciones, obtuvieron puntuaciones relativamente más bajas. En particular, mostraron una tasa de acierto significativamente inferior en preguntas que incluyen imágenes, lo que evidencia un desempeño multimodal rezagado respecto a los modelos líderes globales.
El 20 de este mes, Koo Yu-gyeom, estudiante de la Facultad de Ingeniería de Software Informático de la Universidad Soonchunhyang, presentó públicamente el «Panel de control de resolución de modelo de lenguaje extenso (LLM) para el examen de acceso del año académico 2027».
Según este panel, los modelos que obtuvieron puntuación perfecta en el examen de acceso 2027 fueron el «GPT-6.2 Astra» de OpenAI y el «Gemini 4 Neon» de Google.
El modelo de Anthropic también mostró un desempeño elevado. «Claude Fable 5.2» y «Claude Opus 5.5» registraron respectivamente 449,3 puntos. El «GPT 6.1 Terra» de OpenAI también alcanzó 445,8 puntos.
Los modelos chinos también registraron puntuaciones altas. El «K3.1Pro» de «Kimi», empresa de IA china, obtuvo 438 puntos. Kimi logró puntuación perfecta en las áreas de lengua coreana, inglés e historia coreana, pero obtuvieron 96 puntos en matemáticas y 92 puntos en la sección de exploración.
El modelo «Qwen 4 Max» del grupo Alibaba de China también logró 100 puntos en las áreas de lengua coreana, inglés e historia coreana. En cambio, obtuvo 96 puntos en matemáticas y 88,5 puntos en la sección de exploración.
Por el contrario, los modelos de IA nacionales mostraron una diferencia de puntuación respecto a los modelos líderes globales. El «K-Exaone 2.5» del Instituto de Investigación de IA de LG registró un total de 414,7 puntos, 35,3 puntos por debajo del Astra de OpenAI. Aunque obtuvo puntuación perfecta en matemáticas e historia coreana, logró 98 puntos en lengua coreana, 96 puntos en inglés y solo 70,7 puntos en la sección de exploración.
El «Solar Mini 4.5 Preview» de Upstage registró 397,8 puntos, 52,2 puntos por debajo del modelo con puntuación perfecta. Obtuvo puntuación perfecta únicamente en historia coreana, con 91 puntos en lengua coreana, 95,7 puntos en matemáticas, 96 puntos en inglés y 65,2 puntos en la sección de exploración.
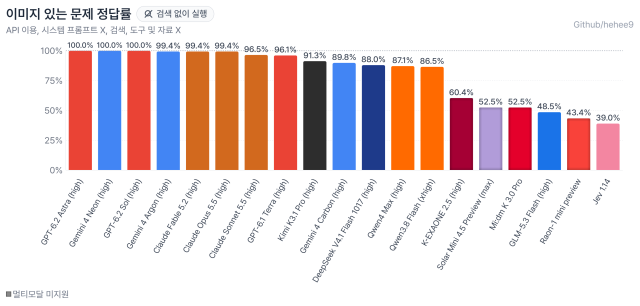
En particular, los modelos nacionales mostraron una tasa de acierto baja en preguntas que incluyen imágenes. La tasa de acierto en preguntas con imágenes fue del 100 % para GPT-6.2 Astra, Gemini 4 Neon y GPT-6.2 Sol. Claude Fable 5.2 y Claude Opus 5.5 también alcanzaron el 99,4 % respectivamente.
En contraste, la tasa de acierto en preguntas con imágenes del K-Exaone 2.5 fue del 60,4 %. El Solar Mini 4.5 Preview registró el 52,5 %. En comparación con Astra, estos niveles son inferiores en 39,6 puntos porcentuales y 47,5 puntos porcentuales respectivamente.
Los expertos analizaron que estas diferencias de rendimiento de los modelos provienen de factores complejos como los datos de aprendizaje, el tamaño del modelo y la capacidad de inferencia. El profesor investigador Choi Byung-ho del Instituto de Investigación de Inteligencia Artificial de la Universidad Korea señaló: «Existe una gran diferencia en la escala de parámetros entre los modelos de las megacorporaciones tecnológicas globales y los de empresas nacionales, así como en el nivel de infraestructura informática disponible en la etapa de inferencia. Las preguntas que incluyen imágenes requieren un proceso de inferencia tras extraer información con precisión mediante tecnología de reconocimiento óptico de caracteres (OCR), y como los modelos de las megacorporaciones han mejorado significativamente el desempeño de sus modelos de inferencia, es inevitable que haya diferencias en los resultados».
Agregó que «la diferencia en datos de aprendizaje es también un factor importante. Es posible que las megacorporaciones tecnológicas globales hayan aprendido previamente sobre preguntas de exámenes anteriores y colecciones de problemas, pero es probable que las empresas nacionales no hayan asegurado suficientemente datos relacionados».
* Este artículo ha sido traducido por IA.