
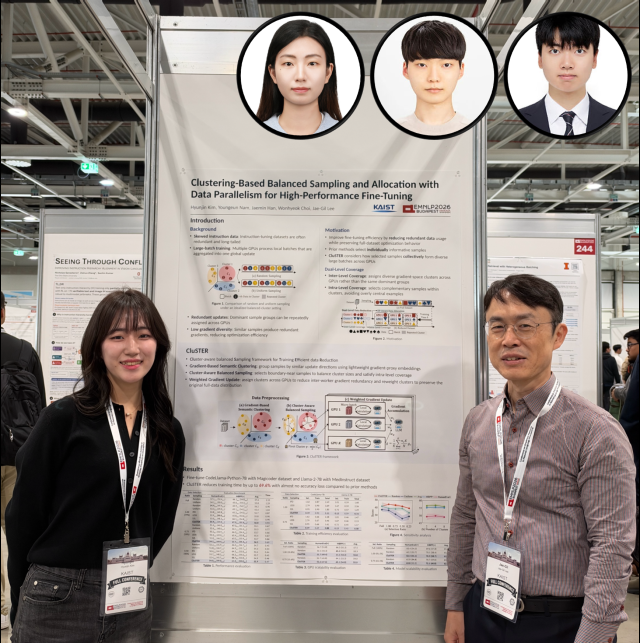
Investigadores del KAIST (Instituto de Ciencia y Tecnología de Corea) han desarrollado una tecnología que reduce hasta un 69,6% el tiempo de entrenamiento adicional necesario para enseñar a sistemas de inteligencia artificial tareas especializadas en campos como medicina y programación. La nueva técnica permite reducir un proceso de aprendizaje que tradicionalmente toma 10 horas a apenas 3 horas, mediante la eliminación de datos con efectos de aprendizaje similares y la distribución equilibrada de información diversa entre múltiples procesadores GPU.
El KAIST anunció que el equipo de investigación del profesor Lee Jae-gil del Departamento de Informática ha desarrollado "CluSTER" (Cluster), una nueva tecnología de ajuste fino para modelos de lenguaje de gran escala que agrupa y selecciona datos según su impacto en el aprendizaje y los distribuye de manera uniforme entre múltiples GPU.
El ajuste fino es un proceso mediante el cual se enseña a una inteligencia artificial con conocimientos generales tareas especializadas, como problemas de programación con sus soluciones o preguntas y respuestas en el campo médico, permitiendo que el sistema se especialice en ese dominio específico. Este proceso requiere grandes cantidades de computación, por lo que múltiples GPU se reparten el trabajo de procesamiento de datos. Los GPU son semiconductores que realizan rápidamente los cálculos necesarios para el entrenamiento de IA. Si los datos se dividen de manera aleatoria, múltiples GPU procesan repetidamente datos que producen efectos de aprendizaje similares. Es como resolver repetidamente problemas similares a los que ya se han resuelto, lo que genera un beneficio de aprendizaje menor en relación con el volumen de cálculo realizado.
CluSTER analiza primero el impacto que cada dato tiene en el aprendizaje de la IA y agrupa datos similares entre sí. No se basa en si abordan el mismo tema o utilizan palabras similares. Si dos problemas aparentemente diferentes enseñan a la IA habilidades de resolución comparables, se clasifican en el mismo grupo. Es el mismo principio que cuando se enseña suma a un estudiante: aunque el problema "combinar dos manzanas y tres manzanas" y el problema "combinar dos lápices y tres lápices" tienen historias diferentes, el método de cálculo que se aprende es el mismo.
Posteriormente, el sistema selecciona datos de cada grupo y los distribuye para que múltiples GPU procesen información de aprendizaje diversa de manera equilibrada. Es como reducir problemas similares en un libro de ejercicios mientras se preservan sin omisiones todos los tipos de problemas esenciales que deben dominarse. Lo característico de este enfoque es que no solo reduce la cantidad de datos, sino que también asegura que múltiples GPU utilicen los datos seleccionados de manera eficiente.
El equipo de investigación realizó experimentos de ajuste fino en modelos de lenguaje de gran escala con aproximadamente 7.000 millones y 13.000 millones de parámetros, utilizando tres tipos de datos de entrenamiento en los campos de programación y medicina, y verificó la efectividad mediante ocho pruebas de evaluación de rendimiento diferentes. Los parámetros son valores numéricos internos que la IA ajusta durante el aprendizaje y que se utilizan para reflejar los conocimientos adquiridos en las respuestas. Al seleccionar solo aproximadamente el 31% del total de datos para el entrenamiento, el rendimiento del modelo se mantuvo prácticamente sin cambios mientras que el tiempo de entrenamiento se redujo un máximo de 69,6%. Los experimentos se realizaron principalmente en un entorno con 4 GPU, y también demostraron un rendimiento superior al de los métodos convencionales en un entorno con 8 GPU.
Este resultado demuestra que es posible mejorar la eficiencia del entrenamiento de IA simplemente mediante una selección y distribución inteligente de materiales de aprendizaje, sin necesidad de invertir en GPU adicionales. Según la explicación del equipo de investigación, empresas e instituciones de investigación pueden reducir el tiempo y los costos de uso de GPU cuando desarrollan sistemas de IA para propósitos específicos, como atención al cliente, soporte de programación y respuestas a consultas médicas.
El profesor Lee Jae-gil señaló: "Para mejorar la eficiencia del entrenamiento de IA, no es suficiente simplemente utilizar más GPU; también es importante elegir inteligentemente qué datos entrenar. Esta investigación es significativa porque demuestra que podemos reducir la carga de entrenamiento de modelos de IA a gran escala aprovechando más eficientemente los recursos de GPU existentes".
* Este artículo ha sido traducido por IA.