
Perplexity, OpenAI, Google y Meta bloquean acceso... Protegiendo ingresos publicitarios de 68 mil millones de dólares
La competencia de agentes de IA se desplaza del rendimiento del modelo hacia el control de datos... Acceso a información será de pago
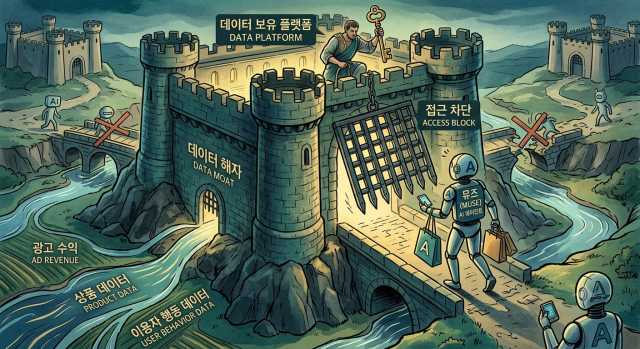
Amazon bloqueó de forma inesperada el acceso del agente de IA personal de Meta, "Muse" (Musa), a su centro comercial en línea. Tras bloquear también a Perplexity, OpenAI y Google, la incorporación de Meta a esta lista marca una tendencia clara: las plataformas que controlan datos están decididas a no permitir acceso gratuito a agentes de IA, reforzando así su "foso de datos" para proteger sus negocios.
Según el sector tecnológico, Amazon comenzó el bloqueo de Muse en Amazon.com a partir del 20 de septiembre. Amazon solicitud a Meta que removiera Muse de su plataforma, pero al ser rechazada, procedió al bloqueo. Actualmente, los usuarios que intentan utilizar Muse para comprar en Amazon ven repetidamente mensajes emergentes indicando violación de términos de servicio.
Muse es un agente de IA para consumidores lanzado por Meta el 8 de este mes, capaz de gestionar reservas de viajes, correo electrónico, calendarios y pagos de forma automática. Disponible en aplicaciones, web y WhatsApp, ofrece un plan gratuito y opciones de pago de 20 y 100 dólares mensuales. Poco después de su lanzamiento, alcanzó el primer lugar en la tienda de aplicaciones, pero en apenas dos semanas fue bloqueado por el mayor centro comercial en línea de Estados Unidos.
Amazon justificó el bloqueo por motivos de seguridad: Meta no notificó previamente, el agente accedió sin identificarse como un bot y aparentemente recopila y almacena información de inicio de sesión de clientes. Meta respondió rechazando estas acusaciones. Tarek Shawash, vicepresidente del Superintelligence Labs de Meta, explicó que la información de inicio de sesión se envía directamente a un almacén de seguridad sin ser visible para el agente principal.
Este bloqueo no es un caso aislado. En el último año, Amazon demandó a Perplexity por el navegador Comet, bloqueó agentes de compra de Google y OpenAI, e incluso modificó su archivo robots.txt para bloquear el acceso de Google, lo que resultó en la desaparición de páginas de productos de Amazon en algunos resultados de búsqueda de IA. Todos los objetivos de estos bloqueos son empresas sin bases de comercio electrónico propias o débiles. La estructura anterior, donde se creaban servicios utilizando datos de centros comerciales ajenos, ahora está siendo cerrada.
La verdadera motivación es el ingreso publicitario. Amazon generó más de 68 mil millones de dólares únicamente de publicidad el año pasado, un negocio que depende de que los usuarios vean productos patrocinados mientras navegan. En el segundo trimestre de este año, los ingresos publicitarios alcanzaron 19.81 mil millones de dólares, un incremento del 26% respecto al año anterior. Cuando un agente elige un producto y completa el pago, todos los puntos de contacto donde Amazon genera ganancias —barras de búsqueda, pantallas de comparación, flujo de pago— desaparecen.
Meta ha empleado la misma lógica en el pasado. En octubre del año pasado, Meta cambió los términos de servicio de WhatsApp Business para bloquear el acceso de chatbots de IA generales como ChatGPT y Perplexity, regulación que entró en vigencia el 15 de enero. Sin embargo, Amazon tampoco está libre de críticas sobre esta doble medida. El servicio "Buy for Me" (Cómpralo por Mí) de Amazon busca productos no disponibles en su plataforma y accede a centros comerciales externos para ingresar automáticamente nombre, dirección e información de pago. Amazon utiliza datos ajenos con su propio agente mientras bloquea los agentes de terceros: una estructura donde unos pueden usar datos externos mientras otros no. Finalmente, el tema no es de principios sino de propiedad de datos.
Las herramientas legales también se están debilitando. En agosto, la Corte Federal de Apelaciones del Noveno Circuito debilitó la estrategia legal de Amazon bajo la Ley de Fraude y Abuso Informático (CFAA), dejando como principal recurso la aplicación de términos de servicio. Los bloqueos técnicos y las negociaciones se han convertido en el frente principal, no los litigios.
La industria prevé que el acceso a datos eventualmente se monetizará. Las grandes tecnológicas podrían establecer "acuerdos de caballeros" sobre datos, o los desarrolladores de agentes pagarían honorarios a quienes poseen los datos. Precedentes ya existen en el sector de contenidos: Google firmó un contrato de licencia de datos con Reddit por 60 millones de dólares anuales. La competencia de agentes de IA está migrando desde el rendimiento del modelo hacia la adquisición de datos de comercio minorista, reservas y contenidos.
Sin embargo, no todas las empresas que poseen datos serán "fuertes". El poder de negociación proviene de datos intercambiables, algo que pocas empresas poseen. La mayoría de las organizaciones que cuentan con datos desconocen su valor o no han procesado sus datos como "datos listos para IA", es decir, datos que pueden ser utilizados directamente por sistemas de IA. Esta es la razón por la que expertos señalan que la transformación de IA corporativa (AX) debe comenzar no con la adopción de modelos, sino con la gestión de datos.
Corea del Sur sigue una dinámica similar. Naver controla datos de búsqueda, compras y blogs; Coupang posee información de productos, precios y envíos; Kakao cuenta con contenidos de su portal Daum. A medida que los agentes globales intensifiquen su entrada al mercado doméstico, las políticas de acceso de estas plataformas se convertirán en el punto de partida para las negociaciones.
* Este artículo ha sido traducido por IA.